2026
2025
2024
2023
2022
2021
2020
2019
2018
2017
2016
2015
2014
2013
2012
2011
2010
2009
Cerca nelle notizie
Cerca nel sito
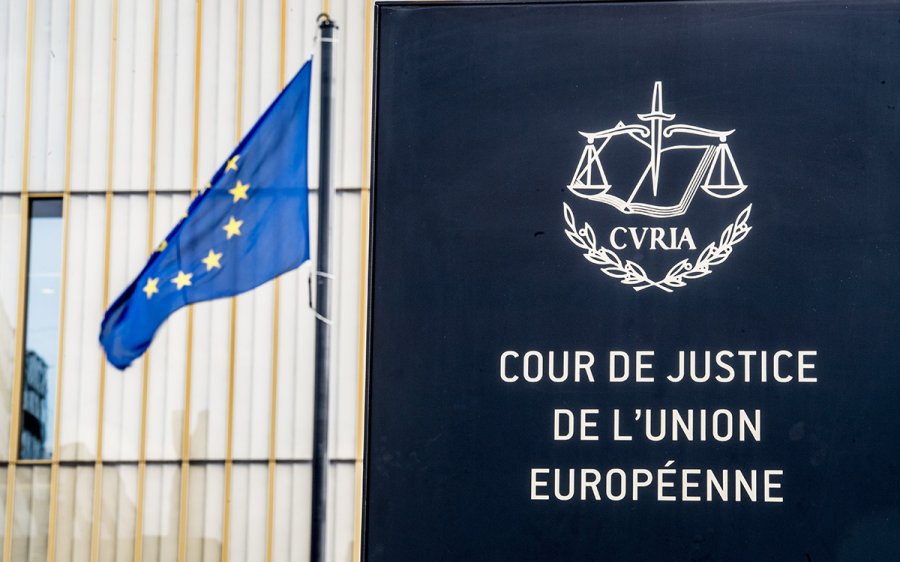
L’esterno della Corte di Giustizia dell’Ue a Lussemburgo (Foto: ImagoEconomica/Fnsi)
Media 03 Nov 2026
Avvocato generale Corte Ue: «L’uso di articoli giornalistici attraverso l’IA può violare i diritti degli editori»
Il parere, su un caso ungherese, è il primo sull'intelligenza artificiale generativa.
«La Corte dovrebbe ritenere che il recupero e il riutilizzo, in tempo reale, di pubblicazioni giornalistiche online da parte di chatbot basati sull'intelligenza artificiale al fine di generare risposte alle domande degli utenti possa, in determinate circostanze, costituire una violazione dei diritti degli editori giornalistici». Nel primo caso relativo all'intelligenza artificiale generativa giunto dinanzi alla Corte di giustizia, l'avvocato generale della Corte di Giustizia Ue Maciej Szpunar chiarisce in quali circostanze tale processo costituisca una violazione dei diritti degli editori giornalistici. Lo riporta l’agenzia Ansa martedì 3 novembre 2026.
Il Gruppo Alphabet, di cui fa parte Google, fornisce un servizio denominato Google Gemini. Google Gemini è un chatbot basato sull'intelligenza artificiale generativa progettato per conversare con gli utenti tramite testo o voce. Tale capacità deriva dai modelli linguistici di grandi dimensioni (Llm). Gli Llm di Gemini utilizzano una tecnologia denominata Retrieval-Augmented Generation, che consente loro di raccogliere informazioni in tempo reale dal World Wide Web al fine di migliorare l'accuratezza e l'affidabilità delle risposte del chatbot. Grazie a tale tecnologia, un chatbot di questo tipo può essere utilizzato per ottenere informazioni relative alle notizie. Per fornire risposte in tal senso, il chatbot spesso estrae articoli di stampa disponibili online. Like Company, un operatore ungherese che gestisce vari portali web, ha intentato un'azione legale contro Google dinanzi al Tribunale regionale di Budapest. Like Company rivendica la tutela degli articoli pubblicati su tali portali in virtù del diritto connesso al diritto d'autore riconosciuto dal diritto dell'Unione europea agli «editori di testate giornalistiche» in relazione all'«utilizzo online» delle loro «pubblicazioni giornalistiche».
L'avvocato generale consiglia alla Corte di concentrarsi sulle questioni relative alle risposte fornite dal chatbot, in quanto queste sono rilevanti nel procedimento principale. A tale riguardo, egli suggerisce che, quando un chatbot basato su modelli di linguaggio (Llm) recupera una pubblicazione dal sito web di un editore giornalistico, riutilizza tale pubblicazione per generare una risposta e fornisce tale risposta all'utente, il diritto dell'editore giornalistico possa essere violato in determinate circostanze. Su questo punto, l'avvocato generale sottolinea che il diritto dell'editore non tutela i semplici fatti riportati nelle pubblicazioni giornalistiche, ma solo la forma specifica di espressione di tali pubblicazioni. Infatti, il suo scopo è quello di proteggere l'investimento necessario alla realizzazione di tale pubblicazione, non di conferire agli editori un monopolio sulle notizie stesse.
Di conseguenza, a suo avviso, il fatto che tale utilizzo di pubblicazioni giornalistiche da parte di un chatbot basato su Llm rientri nel diritto di riproduzione dell'editore dipende da due fattori: in primo luogo, se tale chatbot abbia avuto accesso alla pubblicazione giornalistica in questione in modo illecito, in particolare eludendo misure tecniche efficaci (come un paywall) volte a limitare l'accesso a tale pubblicazione o il web scraping della stessa; e, in secondo luogo, se la risposta fornita all'utente si limiti a riportare i fatti contenuti nella pubblicazione originale o, al contrario, riutilizzi la forma di espressione di tale pubblicazione in modo riconoscibile, al punto che l'utente, leggendo tale risposta, sia del tutto esonerato dall'accedere alla pubblicazione originale. (anc)
Articoli correlati
Media, ok del Consiglio d'Europa alla risoluzione Grippo: stretta su proprietà opache e leggi bavaglio
I siti